一张照片如何变成解好的数独
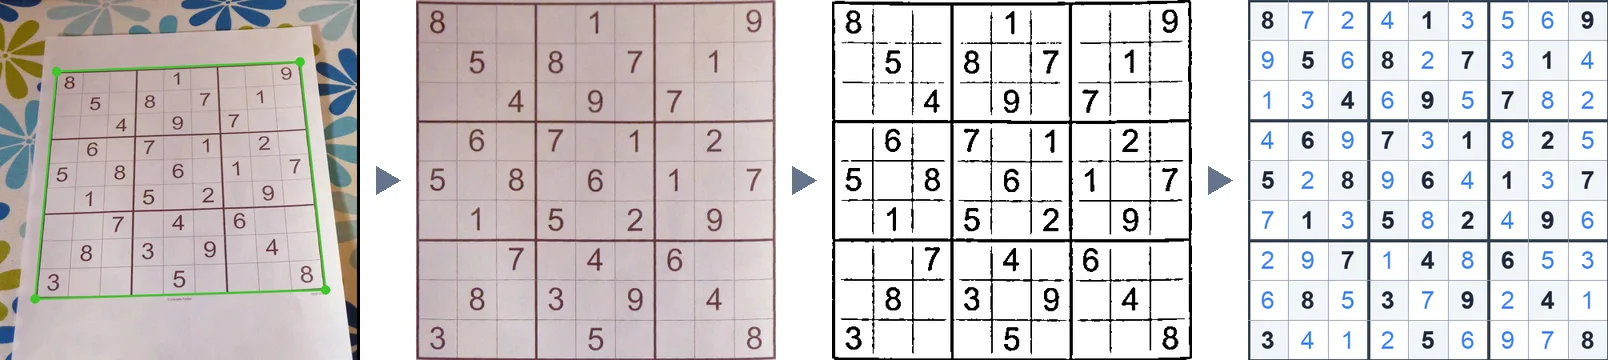
上传一张报纸数独的照片或 App 截图,一秒左右答案就出来了。这篇文章讲中间发生了什么,以及我们怎样保证一个认错的数字不会变成一个错误的答案。
1. 找到网格
第一步先用 OpenCV 做传统的图像处理:找出最大的四边形轮廓,再检查它是不是真的数独。数独在横竖两个方向上各有 10 条等距的线,所以把候选区域拉正后,就看这些位置上有没有线。题目外面的装饰边框、或者只框住了一个 3×3 宫,都过不了这一关;这时会在找到的区域周围拟合出完整的 9×9 网格线。
图片尺寸的影响比想象中大。1200 万像素的照片拍电脑屏幕会出现摩尔纹,而小截图里 1 像素的细线又很容易被滤波抹掉。所以检测会分别在原图和 1280 像素宽的副本上做,取第一个网格线规整的结果。
大约九成的照片 OpenCV 就能找到网格。剩下的,比如反光盖住了网格线、题目装在塑料套里,交给一个小神经网络直接预测四个角点。它为每个角输出一张热力图,而不是直接回归坐标,精度因此高了很多:在测试照片上,角点误差的中位数约为网格边长的 1%。
2. 拉正与清理
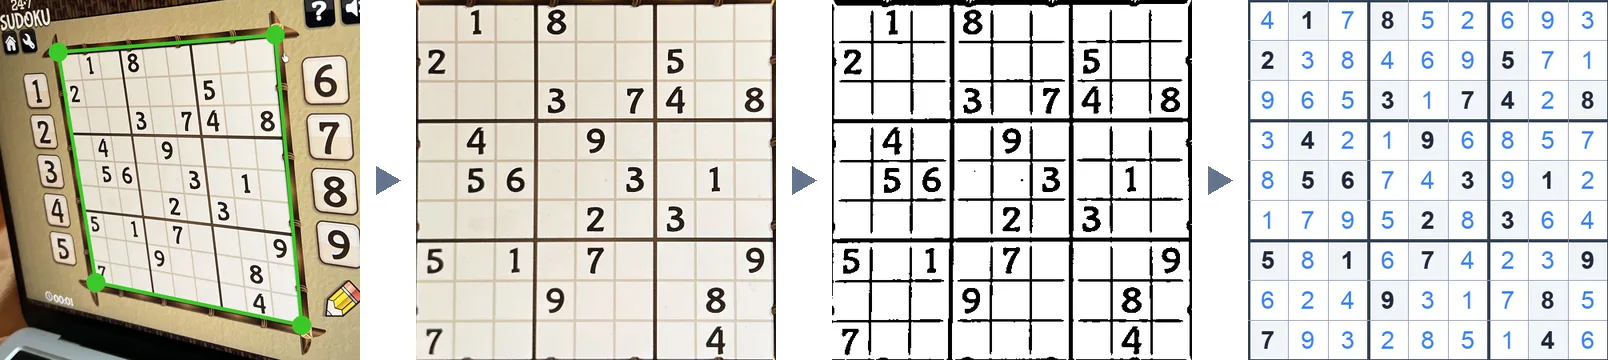
有了四个角点就能做透视变换,把网格映射成一张 450×450 的正方形图片。这一步从原分辨率的照片上截取,小数字也能保持清晰。然后用自适应阈值把图片转成纯黑白:每个像素和它周围的区域比较,阴影、报纸的泛黄、App 的主题色都被去掉了。
3. 识别数字
81 个格子分别切出来,缩放到 48×48 像素,由一个卷积神经网络判断它是空格还是 1–9 中的哪个数字。这个网络很小,只有 3.8 万个参数,在我们的双核服务器上读完 81 格约 8 毫秒。训练数据是我们自己标注的截图和照片,训练时还会故意把角点挪动最多 1.5%,让它适应稍有偏差的网格。
小字号会单独处理:如果一个网格里的数字比训练时见过的都小,就先把格子放大再识别。
4. 用答案来检验识别
能发表的数独只有唯一解。这就给了识别结果一个免费的检验:如果读出来的数字恰好有唯一解,识别几乎肯定是对的;如果无解,说明有数字认错了;如果有很多解,多半是漏掉了数字。
这两种情况求解器都不会直接放弃。网络为每个格子给出按概率排序的候选数字,我们优先尝试网络的「第二选择」,寻找最小的改动(最多两个格子),使题目恰好有唯一解。如果 OpenCV 找到的网格仍然解不出,就轮到角点网络在同一张照片上再试一次。
求解器本身是基于位掩码的回溯搜索,每次优先填合法数字最少的格子。一道普通的题目用时远不到 1 毫秒。
5. 我们怎样保证结果可信
- 新的数字模型必须把每一张已标注的图片都识别完全正确才会上线。一张图片一旦修好,就不会再退步。
- 另有一个由照片和截图组成的独立测试集,从不用于训练或挑选模型,只用来衡量效果。
- 页面上公开实时的解出率,统计所有上传过的不同图片,失败的也算在内。
- 识别错了可以直接改正后重新求解,你的修改会成为训练数据。
目前它还不擅长手写数字、严重模糊,以及网格被照片边缘切掉的情况。如果你的题目没解出来,欢迎上传:这正是下一个模型最需要的图片。
代码开源在 GitHub。